访问量一上来,单台服务器很快就会扛不住。阿里云 SLB(Server Load Balancer,负载均衡)把访问流量分给多台后端服务器,某台机器出问题时可以先把它摘掉,扩容也只需要往后端加机器。这篇文章从基本概念讲起,用一个电商大促的例子说明配置思路,最后列出几个容易踩的坑。
阿里云 SLB 是什么
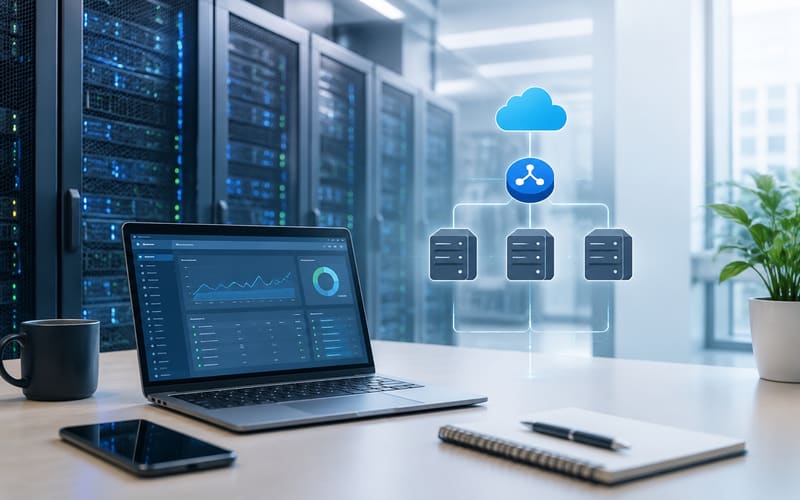
负载均衡位于用户和后端服务器之间。用户访问的是 SLB 提供的统一入口地址,SLB 再按规则把请求转给后端的 ECS 实例。某台后端机器出故障时,SLB 会先把它摘掉,用户一般察觉不到中断。
先认识几个核心概念
- 负载均衡实例:SLB 的载体,会分配一个公网或私网 IP 作为服务入口。
- 监听器:决定前端用什么协议、什么端口接收请求,比如 HTTP 80、HTTPS 443、TCP 3306。
- 后端服务器:真正处理请求的 ECS 实例,每台可以单独设置权重。
- 健康检查:SLB 定时探测后端服务,异常节点会被暂时剔除。
- 转发规则:七层监听可以按域名或 URL 路径,把请求分到不同的服务组。
四层还是七层
四层基于 TCP 和 UDP 转发,只看 IP 和端口,开销小,适合数据库、游戏、长连接这类场景。七层工作在 HTTP 和 HTTPS 层,能读到域名和路径,适合网站与 API,证书也可以集中在负载均衡上处理。
如果只是把请求平均分给几台 Web 服务器,两种都够用。要按路径分流,或者证书需要集中管理,就选七层。
调度算法怎么选
常见的有轮询、加权轮询、加权最小连接数和源 IP 哈希。后端机器配置一致时,加权轮询最省事。长连接业务里,各节点手上的连接数可能差距很大,这时加权最小连接数分得更均匀。如果要让同一用户尽量落在同一台机器上,可以考虑源 IP 哈希或会话保持。
大促前的改造案例
某中型电商团队之前把网站部署在一台 ECS 上。平时还能应付,但每次促销一开始,页面响应就从平时的 200 毫秒左右涨到数秒,偶尔还会出现 502。下面的数据是示意,用来说明改造思路,并非某个真实项目的记录。
团队做了三件事。一是在同一地域的两个可用区各部署 3 台 Web 服务器,共 6 台。二是创建七层负载均衡实例,在 443 端口监听,证书配置在负载均衡上,后端通过内网用 HTTP 访问。三是把健康检查路径设为 /healthz,再根据业务负载调整检查间隔和失败阈值。
大促当天,流量峰值约为平时的五倍。SLB 按加权轮询把请求分到 6 台机器上。其中一台因为内存泄漏在活动中途宕机,健康检查在设定的时间窗口内把它摘掉,其余机器照常服务。用户侧只有少量请求失败,重试一次通常就能成功。
这次改造解决的主要是单点问题。入口统一之后,节点可以多开几台,坏掉一台也不会拖垮整个站点。检查间隔、失败阈值和权重取多少,还是要结合自己业务的压测结果来定。
配置步骤
- 创建负载均衡实例,选好地域、可用区和网络类型。后端 ECS 通常需要和它在同一地域,网络类型也要提前想清楚。
- 添加监听器,选择协议和端口。
- 添加后端服务器,并设置权重。
- 配置健康检查,检查路径要指向一个能真实反映应用状态的接口。
- 需要 HTTPS 时,选择已有证书或上传证书。
- 把域名的 CNAME 或 A 记录指向负载均衡地址,最后用域名访问一次确认。
两个常见误区
第一个误区是以为负载均衡能替代应用层的容错。SLB 只能判断后端能不能响应,修不了业务逻辑的错误。如果应用把登录状态存在本机,请求切到另一台机器时,用户就会突然掉登录。这种情况要把会话放到 Redis 之类的共享存储里,或者开启会话保持。
第二个误区是只看 ECS 的端口开没开。系统端口放行了,不代表应用真的在监听转发用的端口。上线前最好直接在后端机器上访问一遍应用端口,确认服务已经起来。
上线前容易漏掉的几点
- ECS 的安全组要放行负载均衡的访问请求和健康检查请求,否则后端会被判定为异常,流量进不来。
- 七层场景下,后端想拿到真实客户端 IP,需要读取 X-Forwarded-For 请求头。
- 费用包括实例规格、流量等项目,计费规则会调整,上线前到阿里云官网价格页核对一遍。
- 产品名称和配置项会更新,具体以阿里云控制台和官方文档为准。
落地建议
第一次上线,建议先在测试环境验证健康检查和会话保持。确认故障节点能被摘除,恢复后又能重新接入,再把生产流量切过来。切换时保留原来的入口,出问题可以快速回退。