业务量涨起来以后,数据库往往先出问题。一台机器既要扛下单写入,又要扛列表查询和报表,慢查询越积越多,连接数告警隔三差五就来一次。这时很多团队会考虑阿里云上的主从架构:写操作留在主库,读请求分给从库。吞吐能上去,主库出故障时也多一个备用的余地。
主从复制是怎么回事
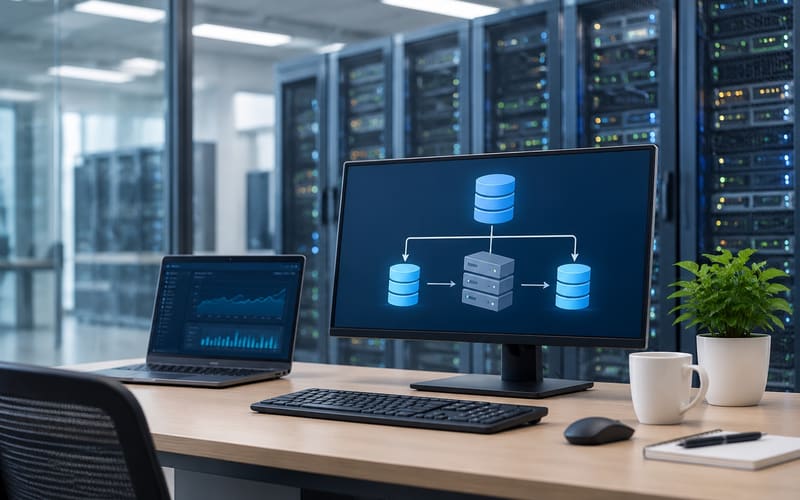
原理不复杂。主库把每一次数据变更记进日志,从库把日志拉过来,在本地重新执行一遍,数据就跟着同步了。以MySQL为例,主库写binlog,从库的IO线程把日志取到中继日志里,SQL线程再去执行。默认情况下这个过程是异步的,所以从库总会落后主库一小段时间。
这段延迟直接决定了读写分离怎么设计。用户刚提交订单就去查详情,如果直接查从库,很可能查不到,看到的是旧数据。这类场景要在设计规则时单独处理。
阿里云上有哪几种主从形态
和主从相关的能力分布在几类产品里,选之前要先分清楚。
- 云数据库RDS MySQL高可用版:默认由主实例和备实例组成,两者位于同一地域的不同可用区。备库对业务不可见,主要负责故障时自动切换。
- 只读实例:可以在RDS上为主实例添加只读实例,专门承接查询流量。报表、列表页这类读多写少的场景比较合适。
- 云数据库Redis主从版:由一个主节点和一个或多个从节点组成,从节点异步同步数据。常用来做缓存读扩展,或者分担热点数据的访问压力。
- 自建主从:在ECS上自己部署MySQL或Redis主从,灵活度最高。代价是备份、监控和切换都要自己维护,人手紧的团队要先想清楚。
具体规格、可添加的只读实例数量和计费方式都会随版本调整。落地前请以阿里云官方文档和控制台的展示为准,别只看别人的截图或博客。
一个电商订单库的改造过程
某中型零售平台的订单库最初是单机RDS。促销期间,后台报表和用户的订单查询同时跑,主库CPU长期超过80%,下单接口明显变慢。团队的改造分三步走。
- 拆分流量:下单、支付回调、库存扣减这些写操作继续走主实例。用户订单列表、历史查询和运营报表改为连接只读实例。
- 处理延迟:支付成功后的订单详情页,对刚产生的订单强制读主库,超过几秒之后再允许读从库。这样用户刷新页面时,不会发现自己的订单不见了。
- 演练故障切换:每月低峰期做一次主备切换,检查应用的连接串能否自动重连,并记下切换耗时。没演练过的切换,真出事时很难判断能不能用。
改造上线后,主库CPU降到40%左右,订单列表接口的平均响应时间降了一半以上。报表任务跑起来的时候,下单链路不再受影响。这次改造让不同类型的流量彼此分开,性能提升反而是顺带的结果。
上线前要盯住的几件事
- 复制延迟告警:给从库设置延迟阈值。延迟超过阈值时,读流量应自动切回主库,否则用户很快会碰到数据不一致。
- 连接层别硬编码:应用通过统一的数据源配置区分读写,不要把读库地址散落在业务代码里。以后换地址或加从库,改一处就够了。
- 大事务要拆:大事务会拖慢从库回放。批量删除、大批量更新最好分批执行,每批之间留一点间隔。
- 只读实例别贪多:每多一个从库,主库要推送的日志就多一份。数量应该按实际查询量来算,而不是看到就加。
- 只读账号单独建:权限只给读操作,通过VPC内网访问,不对公网开放。
选型怎么定
先看业务的读写比例,再看对一致性的要求。读多写少、能接受短暂延迟,适合上只读实例或Redis主从版。对延迟特别敏感、又有自己的运维团队,可以考虑自建。方案定下来以后,盯住延迟、定期演练切换、规范连接配置,比单纯加机器更能让系统稳下来。