很多研发团队都有过类似的经历:代码散落在几个人的电脑上,发版靠一份检查清单,上线前一晚大家守着群消息等结果。流程越长,出错的地方越多。阿里云效把需求、代码、流水线、测试和制品管理放在同一个入口里,适合想把这些环节串起来的团队。下面以一个虚构但有代表性的案例,讲讲怎么一步步落地。
一、问题出在哪里
案例中的团队有十个人左右,负责一个电商后端,代码分在三个仓库里,发布要运维手动执行脚本。每次发版平均要两个多小时,最慢的一次回滚用了四十多分钟。问题主要有三个:需求状态和代码提交对不上;测试环境和生产环境的配置不一致;发布记录散落在聊天记录和表格里,出了问题很难回头查。
二、先理清流程,再选工具
团队没有急着上平台,而是先把从需求到上线的过程画了出来。有两个决定其实和工具无关,却直接决定了平台该怎么配:每个需求对应一个分支,主干只接受评审通过的合并;每次合并都要自动触发构建和基础测试。流程定下来以后,再去看云效的模块该放在哪里,就不容易被功能列表牵着走。
具体对应关系如下:
- 项目管理:需求、任务和缺陷统一放在看板里,提交代码时关联任务编号,状态变化能对得上代码。
- 代码管理:托管 Git 仓库,并配置合并请求的评审规则。至少一名同组成员通过,代码才能合入,避免“谁都能直接推主干”。
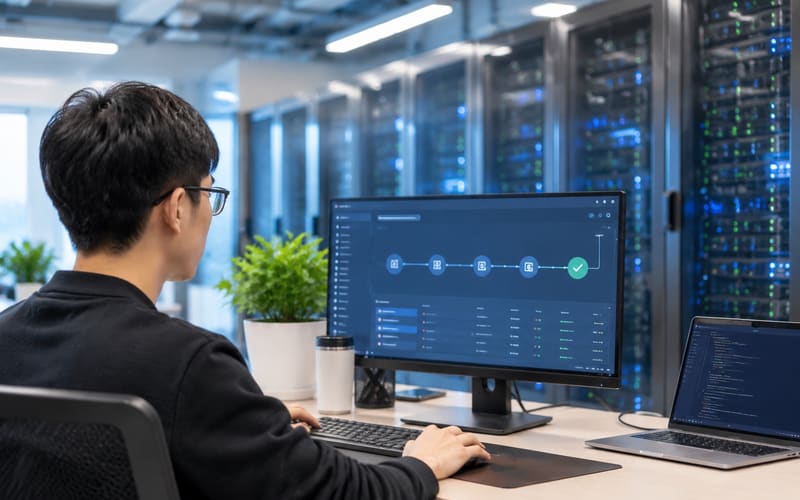
- 流水线:定义构建、单元测试、镜像打包和部署几个阶段。任一阶段失败,后面的步骤都不会执行,问题停在最早出现的地方。
- 制品管理:统一保存构建产物,让测试和生产用的是同一个版本包。
三、流水线落地时的三个细节
1. 构建一次,多处部署
早期团队分别在测试和生产环境构建,两边的依赖版本略有不同,线上问题很难在测试里复现,排查时常常要靠猜。调整之后,流水线只在合并时构建一次,产物写入制品库,各环境都从这里拉取同一个版本。这个改动的意义在于,“测试通过的包就是上线的包”变成了可以核对的事实,而不是一句默认的假设。
2. 环境配置与代码分开
数据库地址、密钥这类参数不再写进代码,改由流水线的环境变量管理,敏感信息加密保存。权限也做了区分:开发人员可以触发测试环境的部署,生产环境的部署需要负责人审批。这样既不耽误日常联调,也不会让一次误操作直接打到线上。
3. 发布前的质量门禁
流水线加了两道检查:单元测试覆盖率不能低于设定的阈值,核心接口的冒烟测试必须通过。上线第一周,这两道关卡就拦下了两次因依赖冲突导致的构建失败,问题没有流入测试环境。门禁的阈值不必一开始就定得很高,先让它稳定运行,再根据实际情况逐步收紧。
四、效果和代价
运行两个月后,团队的平均发版时间从两小时左右降到二十分钟左右。回滚只需要在制品列表里选中历史版本重新部署,不用再翻找脚本和记录。每次上线涉及的需求、提交和负责人都能查到。
过程并不顺利。最初几周,开发人员抱怨流程变慢,合并请求要等很久才有人评审。团队后来约定评审四小时内响应,并为小改动简化了评审规则,抱怨才慢慢少了下来。这件事说明,工具能把流程固定下来,但流程合不合理,还得靠团队在使用中不断调整。
五、准备引入的团队可以参考
- 先梳理现有流程,找出最耗时、最容易出错的环节,再决定先接入哪个模块。如果发版慢是因为手动步骤多,优先做流水线;如果问题多出在需求和代码对不上,先把项目管理和代码管理连起来。
- 选一个小项目试点,验证流水线和权限设计没问题后,再推广到其他项目。试点期间记下哪些步骤总被卡住,这些记录比方案文档更有用。
- 统一分支策略和提交规范。很多团队的流水线配置花了不少时间,效果却不稳定,多半是因为分支和提交习惯本身就不一致。
- 把发布、回滚和审批都纳入流水线,减少对口头约定的依赖。口头说过的事,过一段时间谁也说不清,写进流程里才靠得住。
阿里云效不能替代团队的协作习惯,它的作用是把分散的环节放进同一条可追溯的链路里。对于正从手工运维转向工程化的团队,这是一个值得认真评估的起点。