凌晨刷歌时,播放器一直转圈,评论区也加载不出来。多数人第一反应是网络有问题,重启App、切WiFi、删了重装,折腾半天还是打不开。等刷到微博上一片吐槽,才反应过来大概不是自己的手机。服务端故障通常会同时影响大量用户,所以“网易云服务器炸了”这类话题很快就会出现在社交平台上。
这篇文章不去猜具体原因,只讲三件事:故障时用户会看到什么,服务器一般在哪些环节出问题,以及遇到这种情况时可以先做什么。
一、故障时你会看到什么
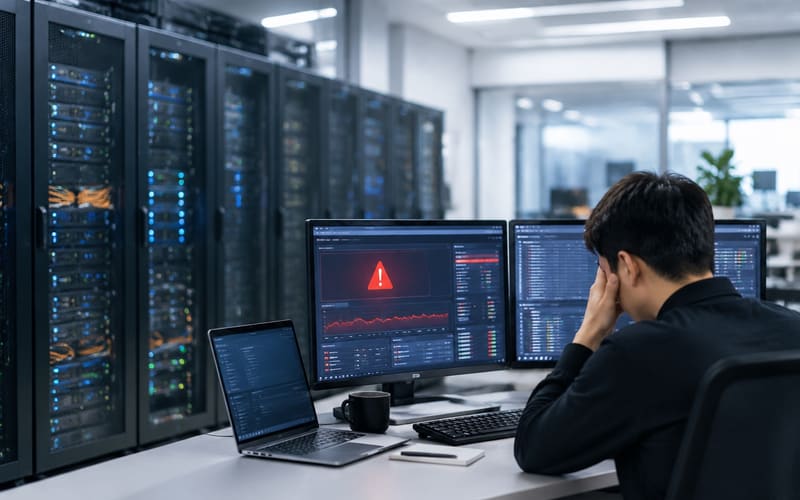
服务端出问题,表现通常是几种症状的组合,很少只有一个报错。常见的有下面几种:
- 打开App后长时间白屏,或者一直停在加载页
- 歌曲加载不出来,或者播放几秒就断
- 收藏、签到、私信这类操作提示“网络异常”
- 评论区空白,热评和点赞数不再更新
这些表现和断网很像,也是最容易误判的地方。如果其他App都能正常上网,只有网易云一直异常,就可以怀疑是平台侧的问题。
二、服务器为什么会出问题
在线音乐平台的请求链路很长。播放地址、歌词、评论、推荐和登录鉴权彼此依赖,其中一个环节卡住,其他模块也可能跟着变慢。事故多半出在下面几类情况:
- 流量突然变大。热门节目、明星动态或者节假日高峰,请求量可能在短时间内涨上去。如果缓存没有命中,请求会直接压到数据库上。
- 上线或配置变更。版本发布、配置调整、数据库迁移都是事故高发时段。变更如果没有分批灰度,问题就可能一下子影响到全部用户。
- 外部依赖抖动。CDN节点、短信验证、第三方支付或云服务的网络波动,都可能把问题传到业务层。
- 容量估计偏差。业务增长快于扩容节奏,或者自动扩缩容的阈值设得不合适,高峰期就容易顶不住。
大型平台一般会做多机房、限流和降级。所以出现大面积不可用时,通常是几道防线同时没有起作用。事后复盘时,只写一句“服务器负载过高”没有太大用处,还得查清楚是哪一步先出了问题。
三、从过往事故能看出什么
从这类事故的常见情况看,问题往往出在操作流程上,硬件本身未必是原因。比较典型的一种是配置错误:一条不该下发的配置进了核心服务,灰度环节又没有拦住。这种问题靠换更好的服务器未必能解决,更需要改的是流程本身。
另一种常见情况是高峰期资源被占满。数据库连接池耗尽后,团队一般只能先紧急扩容、临时限流,并优先保住下单、支付这类主链路,暂时放弃部分非核心功能。这个思路放到音乐平台同样适用:高峰期先保证能听歌,评论实时刷新、推荐内容延后加载都可以接受。
所以稳定性要靠变更管理、容量预估、故障演练和降级预案一起维持,单靠某一次修复撑不住。每一项单看都不起眼,缺了哪一项,都可能在关键时刻出问题。
四、遇到这种情况,可以先做什么
这篇文章没法给出一个固定的恢复时长。每次故障的范围和处理进度都不一样,最可靠的依据还是官方公告里给出的时间点。在等待期间,可以先做这几件事:
- 用其他网络环境再试一次,确认是不是只有网易云异常,排除自己网络的问题
- 关注官方微博、公众号或客服渠道的公告,别只看截图和传言
- 少做重复操作。反复重启和重装解决不了服务端的问题,只会白白消耗流量和时间
- 如果有重要歌单需要整理,先记下歌单名和歌曲数量,等服务恢复后再处理
平台那边,故障后的沟通同样关键。及时说明影响范围、已知进展和下一次更新的时间,比事后一句模糊的致歉更能让用户放心。大多数用户不会要求平台永远不出故障,他们更在意出了问题时有没有人说清楚。
五、结语
这次服务器故障看上去只是一次技术问题,实际牵涉到架构、发布、应急和沟通好几个环节。对开发者来说,它提醒我们稳定性需要长期投入;对用户来说,遇到服务异常时先确认范围,少折腾设备,等官方消息就好。